De la prevenció reactiva a la prevenció predictiva: com les dades i la IA estan transformant la seguretat i salut laboral
La creixent disponibilitat de dades i el desenvolupament de tècniques de machine learning estan ampliant les possibilitats de la prevenció de riscos laborals, la qual cosa permet avançar des d’un enfocament fonamentalment reactiu vers una prevenció anticipatòria. Aquest article analitza el paper dels models predictius en aquesta transformació i n’explica el funcionament i les principals aplicacions per anticipar accidents, estimar-ne la gravetat, identificar períodes de més risc i predir altres resultats relacionats amb la salut laboral. S’aborda especialment el pas de la predicció a l’acció preventiva i es destaca que el valor d’aquests models no resideix únicament en la seva capacitat predictiva, sinó en el seu us per establir prioritats i donar suport a la presa de decisions. Així mateix, s’analitzen les seves principals limitacions, relacionades amb la qualitat i representativitat de les dades, els biaixos, l’explicabilitat i la privacitat. Es conclou que la prevenció predictiva ha d’entendre’s com una eina complementària del coneixement i del criteri professional, orientada a utilitzar millor la informació disponible per actuar abans que es produeixi el mal.
The growing availability of data and advances in machine learning techniques are expanding the possibilities for occupational safety and health (OSH), enabling a shift from a predominantly reactive approach towards more anticipatory prevention. This article examines the role of predictive models in this transformation, explaining how they work and their main applications for anticipating accidents, estimating their severity, identifying periods of increased risk, and predicting other occupational health outcomes. Particular attention is paid to the transition from prediction to preventive action, emphasizing that the value of these models lies not only in their predictive capacity but also in their use for setting priorities and supporting decision-making. The article also discusses their main limitations, including data quality and representativeness, bias, explainability, and privacy. It concludes that predictive prevention should be understood as a tool that complements professional knowledge and judgement, aimed at making better use of available information to act before harm occurs.
La prevenció de riscos laborals (PRL) s’ha basat tradicionalment en l’anàlisi del que ja ha ocorregut. Els accidents de treball, els incidents, les malalties professionals i altres danys relacionats amb el treball proporcionen informació per identificar les seves causes i adoptar mesures destinades a evitar que tornin a produir-se. Aquest enfocament retrospectiu continua sent essencial, però presenta una limitació evident: bona part del coneixement preventiu s’obté després que el mal s’hagi produït.
Al mateix temps, les organitzacions disposen d’una quantitat creixent d’informació sobre les condicions de treball: registres d’accidents i incidents, característiques dels llocs, avaluacions de riscos, exposicions laborals, organització dels torns o durada de les baixes en són alguns exemples. El desenvolupament de tècniques estadístiques avançades i d’aprenentatge automàtic (machine learning) està ampliant la capacitat per analitzar aquestes dades i identificar patrons complexos (Armenteros-Cosme et al., 2025), que poden passar inadvertits mitjançant aproximacions convencionals.
Sorgeix així una pregunta especialment rellevant per a la PRL: podem utilitzar la informació acumulada sobre el passat per anticipar on, quan o sota quines circumstàncies és més probable que es produeixi un mal? Aquesta és la lògica dels models predictius. Diferents recerques han mostrat la seva aplicació en la predicció de l’ocurrència i gravetat dels accidents (Ait Lamkademe i Naddami, 2026) i també en altres resultats relacionats amb la seguretat i salut laboral (Luo et al., 2023; Obasi i Benson, 2025).
Aquestes eines obren la possibilitat d’avançar des d’una prevenció fonamentalment reactiva a una altra més proactiva i predictiva. No obstant això, predir no significa endevinar. Els models proporcionen estimacions probabilístiques la fiabilitat de les quals depèn, entre altres factors, de la qualitat i representativitat de les dades utilitzades. Per tant, el seu veritable interès preventiu resideix no sols en la seva capacitat per anticipar determinats resultats, sinó en convertir aquestes prediccions en informació útil per decidir on i com actuar.
Aquest article analitza què són els models predictius, les seves principals aplicacions en PRL i les oportunitats i limitacions que planteja la seva utilització com a eina de suport a la presa de decisions preventives.
Històricament, la PRL ha generat una gran quantitat d’informació. Accidents i incidents, índexs de sinistralitat, recerques d’accidents, mesuraments higiènics, resultats de la vigilància de la salut, absentisme o característiques dels llocs de treball constitueixen fonts de dades habituals a les organitzacions. No obstant això, bona part d’aquesta informació s’ha utilitzat tradicionalment amb una finalitat descriptiva o explicativa. Watkins et al. (2025) assenyalen que l’avaluació de l’acompliment en seguretat s’ha sustentat tradicionalment en indicadors retrospectius (lagging indicators), vinculats a esdeveniments ja ocorreguts i, per tant, de naturalesa essencialment reactiva.
El desenvolupament de noves capacitats de tractament de dades permet ampliar aquest enfocament. La revisió sistemàtica feta per Maheronnaghsh et al. (2023) mostra que les tècniques de machine learning (ML) ja s’utilitzen en seguretat i salut laboral per a diferents tasques de classificació, predicció i avaluació del risc. En la mateixa direcció, Armenteros-Cosme et al. (2025) constaten una expansió recent dels models predictius aplicats a la prevenció i destaquen la seva capacitat per treballar amb múltiples variables i identificar patrons que poden ser difícils de reconèixer mitjançant aproximacions analítiques convencionals.
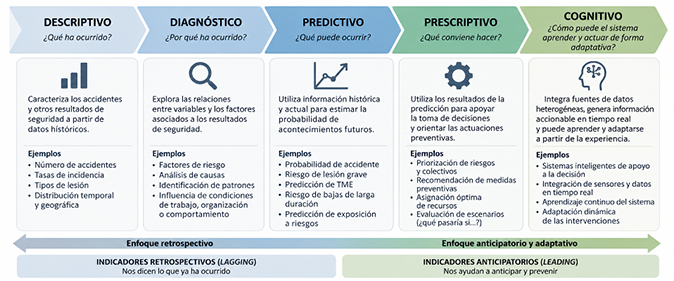
Aquesta evolució, recollida a la figura 1, pot interpretar-se a partir de diferents nivells d’utilització de les dades: descriptiu, diagnòstic, predictiu, prescriptiu i cognitiu (Ezerins et al., 2022). L’anàlisi descriptiva respon fonamentalment a la pregunta què ha ocorregut? i permet caracteritzar els accidents i altres resultats de seguretat a partir de dades històriques. L’anàlisi diagnòstica tracta d’avançar vers per què ha ocorregut?, explorant les relacions entre les variables i els factors associats a aquests resultats. L’anàlisi predictiva modifica la perspectiva temporal i planteja: què pot ocórrer?, usant informació històrica i actual per estimar la probabilitat d’esdeveniments futurs. L’anàlisi prescriptiva trasllada la pregunta vers què convé fer?, utilitzant els resultats de la predicció per donar suport a la presa de decisions. Finalment, l’anàlisi cognitiva representa un nivell addicional de sofisticació, en què sistemes capaços d’integrar fonts de dades heterogènies generen informació accionable en temps real i poden aprendre i adaptar-se a partir de l’experiència.
Figura 1. Evolució de l’ús de les dades en prevenció de riscos laborals
Font: elaboració pròpia a partir d’Ezerins et al. (2022)
En PRL, el salt entre els dos últims nivells és especialment rellevant. Un model pot, per exemple, identificar quines situacions presenten una probabilitat més alta d’accident o quines podrien associar-se amb conseqüències més greus. Però una predicció, per precisa que sigui, no constitueix per si mateixa una intervenció preventiva. El seu valor apareix quan permet prioritzar recursos, intensificar controls o dirigir les actuacions cap a aquells escenaris en què poden ser més necessàries (Huang et al., 2018). El plantejament d’aquests autors és especialment pertinent perquè situa la predicció dins d’una seqüència que condueix des de l’anàlisi de les dades fins a la decisió i, finalment, l’acció en seguretat.
Aquesta transició no implica substituir els instruments tradicionals de la prevenció. La recerca d’accidents, l’avaluació de riscos o el coneixement expert continuen sent necessaris per interpretar adequadament els resultats. Els models predictius afegeixen una capacitat diferent: utilitzar l’experiència acumulada en les dades per anticipar escenaris i donar suport a la decisió sobre on i quan intervenir. Per tant, la qüestió no és triar entre prevenció tradicional i prevenció predictiva, sinó integrar totes dues aproximacions en un procés de presa de decisions més ben informat.
Els models predictius utilitzen dades disponibles per identificar patrons i estimar la probabilitat que es produeixi un determinat resultat. La seva construcció requereix definir, en primer lloc, què es vol predir (variable resultat) i quina informació pot contribuir a aquesta predicció (variables predictores). En PRL, aquestes últimes poden procedir de fonts molt diverses, com ara registres d’accidents i incidents, característiques dels llocs i les tasques, condicions ambientals o informació generada per inspeccions i altres activitats preventives. Les revisions recents mostren que les tècniques de machine learning permeten analitzar conjuntament múltiples variables i abordar diferents problemes de classificació i predicció en seguretat i salut laboral (Maheronnaghsh et al., 2023; Armenteros-Cosme et al., 2025).
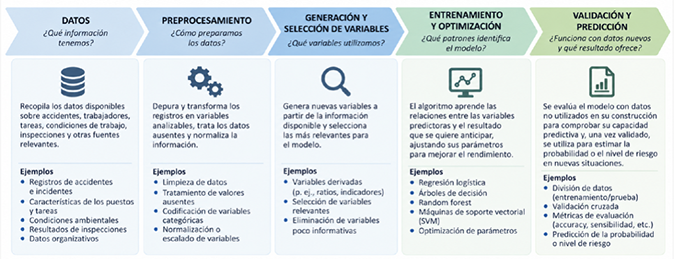
La construcció d’un model comprèn diferents etapes: preparació de les dades, entrenament, validació i predicció. En primer lloc, els registres disponibles han de transformar-se en variables analitzables i seleccionar-se aquelles que poden aportar informació rellevant. Posteriorment, durant l’entrenament, l’algorisme aprèn els patrons que relacionen aquestes variables amb el resultat que es pretén anticipar. Finalment, el model ha d’avaluar-se utilitzant dades que no hagin intervingut en la seva construcció per comprovar si manté la seva capacitat predictiva davant noves observacions. La figura 2 sintetitza aquest procés, des de les dades inicialment disponibles fins a l’obtenció d’una estimació de risc. En una aplicació sobre registres d’accidents d’una planta siderúrgica, Sarkar et al. (2019) van seguir precisament una seqüència de preprocessament, generació i selecció de variables, entrenament, optimització i validació de diferents models.
Figura 2. Procés simplificat de construcció d’un model predictiu en PRL
Font: elaboració pròpia a partir de Sarkar et al. (2019)
Com s’aprecia a la columna «Dades» de la figura 2, sovint, la font més rica d’informació en PRL no es troba solament en bases de dades estructurades, com ara els registres d’accidents i incidents, sinó també en text lliure, com ara les descripcions narratives dels accidents, les avaluacions qualitatives o les notes dels inspectors. En aquest sentit, la irrupció del processament de llenguatge natural (NLP, per les seves sigles en anglès) i, més recentment, dels grans models de llenguatge (LLM, per les seves sigles en anglès), permet extreure automàticament variables predictores a partir d’aquests textos o dades no estructurades. En transformar fonts de dades complexes en variables analitzables, aquestes tecnologies enriqueixen substancialment la capacitat del model per capturar matisos que escaparien a una recollida de dades purament tabular.
A més, no hi ha un únic algorisme adequat per fer prediccions. Poden emprar-se des de models paramètrics tradicionals, com ara la regressió logística o arbres de decisió, fins a tècniques d’ensemble learning com ara Random Forest o Gradient Boosting (per exemple, XGBoost, LightGBM, CatBoost), i també arquitectures de xarxes neuronals artificials. Yapi et al. (2026) van comparar diferents famílies de models per predir accidents laborals a curt termini a partir, entre altres variables, d’informació procedent d’inspeccions de seguretat. La seva anàlisi va incloure models estadístics, arbres, mètodes de boosting i diferents arquitectures de xarxes neuronals. Un resultat especialment rellevant és que una complexitat més gran no garanteix necessàriament una millor capacitat predictiva, perquè el rendiment dels diferents algorismes depèn de les característiques de les dades i del problema analitzat.
Per això, l’avaluació del model constitueix una etapa fonamental. L’exactitud global (global precision) pot ser enganyosa quan l’esdeveniment que es pretén anticipar és poc freqüent, com succeeix habitualment amb els accidents laborals (Topolska et al., 2026). Un model podria classificar correctament la majoria de les situacions simplement perquè en aquestes no ocorre cap accident i, no obstant això, detectar malament precisament els casos de més interès preventiu. Per aquesta raó, el rendiment s’avalua utilitzant mètriques robustes davant classes desequilibrades, com ara la sensibilitat o recall, la precisió (precision), el valor F1 (F1-score) o l’exactitud balancejada (balanced accuracy). Yapi et al. (2026) recorren a aquesta mena de mètriques i a procediments de validació temporal per avaluar el comportament dels models davant dades posteriors a les utilitzades durant el seu entrenament.
Finalment, és important precisar què significa realment predir en aquest context. Un model predictiu no determina quin accident ocorrerà ni quan succeirà exactament. Habitualment, estima una probabilitat o un nivell de risc que permet identificar situacions o períodes que mereixen més atenció. Yapi et al. (2026) assenyalen, de fet, que predir la data exacta d’un accident rares vegades és factible i plantegen com a objectiu més realista identificar intervals temporals amb un risc elevat. Per tant, la predicció ha d’entendre’s com una estimació probabilística basada en patrons presents en les dades, no com una certesa sobre esdeveniments futurs.
La prevenció predictiva pot orientar-se a diferents resultats segons el problema que es vulgui abordar. El més immediat és l’ocurrència d’accidents i incidents, estimant la probabilitat que es produeixin en determinades situacions, activitats o períodes. En aquest àmbit, també els near misses poden aportar informació rellevant en actuar com a senyals precursors d’esdeveniments posteriors (Sarkar et al., 2019; Topolska et al., 2026; Yapi et al., 2026). Un segon àmbit és la gravetat dels accidents. Anticipar les seves possibles conseqüències permet distingir situacions que no necessàriament presenten una probabilitat d’ocurrència més alta, però que podrien generar danys especialment importants (Luo et al., 2023; Obasi i Benson, 2025; Li et al., 2025). Des del punt de vista preventiu, aquesta distinció és rellevant, perquè probabilitat i gravetat representen dimensions diferents del risc.
La predicció pot incorporar també una dimensió temporal. Més que intentar determinar el moment exacte en què es produirà un accident, l’objectiu pot ser identificar períodes en què la seva probabilitat augmenta. Aquest plantejament permet detectar variacions del risc a curt termini i és especialment interessant per a activitats en què les condicions de treball canvien amb freqüència (Yapi et al., 2026). La predicció es converteix així en una eina per reconèixer finestres temporals en què pot ser necessari intensificar l’atenció preventiva.
El camp d’aplicació és encara més ampli quan es consideren altres resultats relacionats amb la salut laboral. Els models predictius poden orientar-se, per exemple, a trastorns musculoesquelètics i riscos ergonòmics (Chan et al., 2022), absentisme i baixes potencialment prolongades (Llamas Blázquez, 2025) i també a altres riscos relacionats amb la salut, com ara la fatiga o l’exposició a agents perillosos (Armenteros-Cosme et al., 2025). La literatura recull aplicacions en contextos molt diversos, com ara la construcció (Luo et al., 2023; Topolska et al., 2026; Umar i Haque, 2026), les indústries extractives (Li et al., 2025), la indústria manufacturera (Sarkar et al., 2019), l’agricultura (Mermer et al., 2026), el sector sanitari (Alcaide et al., 2026a) i la gestió de residus (Yapi et al., 2026), entre altres.
Aquesta diversitat reforça el caràcter transversal de la prevenció predictiva: els resultats que interessa anticipar i les variables disponibles canvien entre activitats, però la lògica predictiva pot aplicar-se a problemes preventius molt diferents. En conjunt, permet anticipar si pot produir-se un accident, estimar les seves possibles conseqüències, detectar quan augmenta el risc o identificar la probabilitat de determinats danys per a la salut. No obstant això, conèixer anticipadament el risc només adquireix veritable valor preventiu quan aquesta informació es tradueix en una decisió. La qüestió passa llavors de què podem predir a què fem amb aquesta predicció.
La capacitat d’anticipar un resultat no constitueix per si mateixa una actuació preventiva. Un model pot identificar situacions amb més probabilitat d’accident, períodes de risc elevat o escenaris associats amb conseqüències més greus, però la predicció només adquireix valor quan condueix a una decisió i, finalment, a una intervenció. El potencial de les dades resideix precisament en la seva capacitat per generar informació útil per decidir i actuar, i no únicament a millorar el coneixement sobre els riscos (Huang et al., 2018).
En la pràctica, les prediccions poden utilitzar-se per establir prioritats preventives. Identificar determinades tasques, condicions o períodes amb un nivell de risc superior permet concentrar en aquests l’atenció i els recursos disponibles. Això pot traduir-se en prioritzar inspeccions, revisar condicions de treball, reforçar controls o intensificar la supervisió quan calgui. D’aquesta manera, la predicció introdueix una dimensió anticipatòria en la presa de decisions: no es tracta d’esperar que es produeixi el mal per actuar, sinó d’utilitzar la informació disponible per orientar la intervenció abans que ocorri (Yapi et al., 2026).
No obstant això, identificar on o quan hi ha més risc no determina automàticament quina mesura preventiva ha d’adoptar-se. Per tant, convé distingir dues decisions complementàries: la predicció pot ajudar a determinar on i quan actuar, mentre que l’evidència científica pot contribuir a decidir com actuar. L’elecció entre mesures tècniques, organitzatives, formatives, ergonòmiques o d’un altre tipus requereix considerar el coneixement disponible, les característiques específiques del context i el criteri dels professionals de la prevenció. Els models predictius han d’entendre’s com a eines de suport a la decisió, integrades en el procés preventiu i no com a mecanismes autònoms de decisió.
Aquest pas de la predicció a la intervenció constitueix encara un dels principals reptes de la prevenció predictiva. La literatura mostra que el desenvolupament d’eines per identificar i anticipar riscos ha avançat més ràpidament que l’evidència disponible sobre la seva implementació efectiva en els processos preventius (Chan et al., 2022; Jetha et al., 2025). Per això, una elevada capacitat predictiva no pot confondre’s amb una elevada efectivitat preventiva. Un model pot identificar correctament situacions de més risc i, no obstant això, no produir cap millora si aquesta informació no genera una actuació adequada o si les mesures adoptades no són efectives.
El procés tampoc hauria de finalitzar amb la intervenció. Les mesures adoptades han de ser avaluades posteriorment per comprovar si han reduït el risc o millorat els resultats de seguretat i salut (Jetha et al., 2025). La prevenció predictiva requereix integrar-se en un cicle de vida continu (habitualment gestionat mitjançant pràctiques de MLOps): ingesta de dades → entrenament del model → predicció → priorització → intervenció → avaluació → monitoratge del model i reentrenament enfront de variacions en l’entorn laboral (concept drift). A més, des d’un punt de vista tècnic, aquest cicle no ha de considerar-se estàtic. Els entorns laborals són dinàmics: la introducció de nova maquinària, la rotació de plantilles o els canvis organitzatius alteren progressivament les condicions de treball subjacents. Quan això ocorre, els algorismes pateixen el que es coneix com a deriva de concepte (concept drift), cosa que fa que les seves prediccions perdin fiabilitat amb el pas del temps. Per això, la implementació real d’aquests sistemes exigeix adoptar un enfocament d’operacions de machine learning (MLOps), que garanteixi el monitoratge continu del rendiment del model en producció i el seu reentrenament periòdic per adaptar les seves inferències a la realitat canviant de l’empresa.
Els resultats obtinguts per aquest cicle no estàtic generen, al seu torn, nova informació que pot contribuir a millorar futures decisions i afavorir l’aprenentatge preventiu de l’organització. L’objectiu últim no és disposar d’algorismes cada vegada més sofisticats per se, sinó utilitzar la informació que generen per intervenir millor i fer-ho abans que es produeixi el mal.
La capacitat d’un model predictiu depèn, en gran manera, de la qualitat de les dades amb què s’ha construït. Registres incomplets, errors de classificació, diferències en els criteris de notificació o informació poc representativa poden afectar directament les prediccions. A més, en PRL, moltes de les dades disponibles procedeixen d’accidents, incidents, inspeccions o avaluacions recollides originalment amb altres finalitats. Per això, disposar d’un gran volum d’informació no garanteix necessàriament disposar de dades adequades per predir: la seva qualitat, consistència i representativitat són determinants (Ezerins et al., 2022; Baraza i Torrent-Sellens, 2026).
Els models també poden reproduir o amplificar els biaixos presents en les dades històriques. Determinats accidents, treballadors o situacions poden estar infrarepresentats, perquè els esdeveniments greus solen ser molt menys freqüents que els lleus. Aquest desequilibri és especialment rellevant en PRL: un model pot presentar una elevada exactitud global i, al mateix temps, tenir dificultats precisament per identificar els esdeveniments menys freqüents i potencialment més crítics (Luo et al., 2023; Li et al., 2025). Per mitigar aquest problema matemàtic de classes desequilibrades, l’enginyeria aplica estratègies específiques durant la fase d’entrenament. Entre aquestes destaquen les aproximacions algorísmiques, com ara l’aprenentatge sensible al cost (cost-sensitive learning), que penalitza dràsticament l’algorisme quan no prediu un accident greu, o les tècniques de remostratge de dades, com ara la generació de dades sintètiques de la classe minoritària (per exemple, mitjançant l’algorisme SMOTE). L’aplicació d’aquestes tècniques és un pas ineludible per garantir que el model no normalitzi el risc ignorant els escenaris de més criticitat. Per tant, l’avaluació ha de considerar no sols el rendiment general del model, sinó també quins casos identifica correctament i quins deixa sense detectar.
Una tercera qüestió és l’explicabilitat. Una predicció és preventivament més útil quan permet comprendre quines variables han contribuït a identificar una situació com de més risc. Per resoldre aquest problema, les tècniques d’intel·ligència artificial explicable (Explainable Artificial Intelligence, XAI) obren la «caixa negra» dels algorismes. L’ús de mètodes matemàtics d’atribució local, com ara SHAP (Shapley Additive exPlanations) o LIME, permet a un tècnic de PRL entendre per què el model ha pres una decisió concreta. Amb aquestes eines, el sistema no es limita a emetre una alerta cega (per exemple, «Risc d’incident del 80 %»), sinó que detalla la seva justificació probabilística: «Risc alt a causa de: variable A (acumulació d’hores extres l’última setmana) i variable B (torn nocturn actual)». Aquesta transparència algorísmica és la que veritablement facilita la interpretació clínica de la dada i afavoreix la confiança i utilització dels resultats per part dels professionals (Armenteros-Cosme et al., 2025; Obasi i Benson, 2025). La transparència i l’explicabilitat adquireixen especial importància quan els models incorporen informació individual, perquè apareixen també qüestions relacionades amb la privacitat, l’equitat i el possible ús inadequat de les dades (Baraza i Torrent-Sellens, 2026; EU-OSHA, 2022).
Aquestes limitacions no invaliden el potencial de la prevenció predictiva, però sí que condicionen la seva utilització. La qualitat de les dades, el control dels biaixos, l’explicabilitat i la protecció de la informació han de considerar-se juntament amb la capacitat predictiva del model. Sobretot, una estimació algorísmica no hauria d’interpretar-se com una decisió automàtica: requereix coneixement del context, valoració preventiva i supervisió humana (Baraza i Torrent-Sellens, 2026; EU-OSHA, 2022). Per tant, el repte no consisteix a substituir el criteri professional per un algorisme, sinó a determinar com poden combinar-se tots dos per a millorar la presa de decisions. De fet, la recerca sobre l’eficiència predictiva ja ha assenyalat quina és la millor combinació de dades i coneixements per optimitzar aquesta relació. Aquesta ens suggereix que apliquem la complementarietat d’intel·ligències (entre intel·ligència artificial, IA, i intel·ligència humana, IH) en funció de les diferents categories de la predicció i els components de la presa de decisions (Torrent-Sellens, 2025). A la taula 1 es reprodueix aquest context. És a dir, s’analitzen els punts forts i febles de la IA i la IH en funció de les característiques de les dades i els coneixements en la presa de decisions sobre predicció en una organització econòmica. Quant a la predicció, la IA optimitza les seves capacitats en contextos de coneixements coneguts, és a dir, en situacions de predicció amb fenòmens coneguts i abundants dades. Per part seva, la IH és molt més versemblant que la IA en contextos de desconeixements coneguts, és a dir, en situacions de predicció de fenòmens poc o gens coneguts i amb poques dades. En aquests contextos, algunes de les habilitats de la IH, com ara les nostres capacitats innates i intuïtives per reconèixer-nos, comparar-nos o adaptar-nos a noves circumstàncies, són de gran utilitat per a la previsió.
Taula 1. La matriu de confusió per a la presa de decisions en IA + IH
| Coneixements | |||
| Coneguts | Desconeguts | ||
| Dades | Abundants | Coneixements coneguts (moltes dades d’un tema conegut) IA: frau, diagnòstics mèdics, sentències judicials |
Coneixements desconeguts (moltes dades d’un tema desconegut) IA falla: causalitat inversa, variables omeses IA + IH: anàlisi contrafactual i explicabilitat de la IA |
| Escassos | Desconeixements coneguts (poques dades sobre un tema conegut; prediccions amb poques dades) IH: reconeixements, analogies, intuïció |
Desconeixements desconeguts (poques dades sobre un esdeveniment que no ha succeït mai) Ni IA, ni IH: creació creativa, innovacions radicals inesperades |
|
Font: Torrent-Sellens (2025)
La incorporació de models predictius a la PRL no hauria de plantejar-se com una substitució dels professionals, sinó com una ampliació de la seva capacitat per interpretar informació i anticipar riscos. Els algorismes poden processar grans volums de dades, identificar patrons difícils de reconèixer mitjançant aproximacions convencionals i generar estimacions que ajudin a establir prioritats. No obstant això, transformar aquestes estimacions en decisions preventives requereix comprendre les condicions reals de treball, valorar les seves implicacions i seleccionar les actuacions més adequades. Per tant, el valor d’aquestes eines resideix a combinar la capacitat analítica dels models amb el coneixement i el criteri professional (Baraza i Torrent-Sellens, 2026).
Aquesta complementarietat pot afavorir una prevenció més dinàmica i anticipatòria. Enfront d’indicadors que descriuen esdeveniments ja ocorreguts, la disponibilitat creixent de dades permet incorporar senyals capaços d’advertir canvis en les condicions de risc (Watkins et al., 2025). La progressiva aplicació del machine learning en seguretat i salut laboral mostra les possibilitats d’aquesta evolució (Maheronnaghsh et al., 2023). L’objectiu no hauria de ser aspirar a predir tots els accidents, sinó millorar progressivament la capacitat per reconèixer situacions que requereixen atenció i actuar abans que el mal es materialitzi.
Aquest escenari també implica una evolució de les competències dels professionals de la prevenció (Alcaide et al., 2026b). No caldrà que tots es converteixin en especialistes en machine learning, però sí que puguin comprendre quina informació utilitza un model, interpretar adequadament els seus resultats i reconèixer les seves limitacions. L’alfabetització en dades i una comprensió bàsica dels models predictius seran necessàries per usar-los de manera crítica i convertir els seus resultats en coneixement preventiu útil (Alcaide et al., 2026b). D’aquesta manera, la tecnologia modifica no sols les eines disponibles, sinó també les capacitats necessàries per usar-les adequadament.
En definitiva, el futur de la prevenció predictiva dependrà menys de disposar d’algorismes cada vegada més complexos que d’aconseguir integrar-los adequadament en la gestió preventiva. La tecnologia pot contribuir a detectar patrons, anticipar escenaris i orientar prioritats; el professional aporta el coneixement del context necessari per interpretar aquesta informació i transformar-la en acció. La prevenció predictiva no suposa substituir una manera de fer prevenció per una altra, sinó incorporar una nova capacitat per anticipar-se al risc i prendre decisions més ben informades.
Els models predictius amplien les possibilitats de la PRL en permetre utilitzar les dades disponibles no sols per comprendre l’ocorregut, sinó també per anticipar accidents, estimar les seves conseqüències i identificar situacions que requereixen més atenció preventiva. La seva aplicació en diferents resultats i sectors mostra el potencial d’avançar cap a una prevenció més anticipatòria.
No obstant això, predir no equival a prevenir. El valor d’aquests models depèn del fet que els seus resultats es tradueixin en prioritats, decisions i intervencions efectives, i que posteriorment s’avaluï el seu impacte. Al mateix temps, la qualitat de les dades, els biaixos, l’explicabilitat i la privacitat condicionen la seva utilització responsable.
El futur de la prevenció predictiva no passa per substituir el criteri professional, sinó per combinar la capacitat analítica dels algorismes amb el coneixement preventiu. L’objectiu final no és predir més, sinó utilitzar millor la informació disponible per actuar abans que es produeixi el mal. Tenir en compte les característiques de les dades i els esdeveniments a predir és un bon punt de partida per exercir la complementarietat d’intel·ligències en PRL.
AIT LAMKADEME, Hajar; NADDAMI, Ahmed (2026). «Predictive analysis of causal factors influencing occupational accidents in construction workplaces using a machine learning unified data model». International Journal of System Assurance Engineering and Management, vol. 17, pàg. 2140-2159. DOI: https://doi.org/10.1007/s13198-025-03064-0
ALCAIDE, Neus; BARAZA, Xavier; COMBE, Gemma; CORRONS, August.; FICAPAL-CUSÍ, Pilar; NOS, Isabel. (2026a). «Predicting musculoskeletal sick leave in tertiary hospital staff using classification trees for targeted ergonomic intervention». Work: A Journal of Prevention, Assessment and Rehabilitation. DOI: https://doi.org/10.1177/10519815261489557
ALCAIDE, Neus; BARAZA, Xavier; FICAPAL-CUSÍ, Pilar (2026b). «From technical skills to future competencies: training and development of occupational health and safety professionals». International Journal of Training and Development. DOI: https://doi.org/10.1111/ijtd.70037
ARMENTEROS-COSME, Pablo; ARIAS-GONZÁLEZ, Marcos; ALONSO-ROLLÁN, Sergio; MÁRQUEZ-SÁNCHEZ, Sergio; CARRERA, Albano (2025). «Advancements in artificial intelligence and machine learning for occupational risk prevention: A systematic review on predictive risk modeling and prevention strategies». Sensors, vol. 25, num. 17, art. 5419. DOI: https://doi.org/10.3390/s25175419
BARAZA, Xavier; TORRENT-SELLENS, Joan (2026). «Artificial intelligence and emerging risks in occupational safety and health». Encyclopedia, vol. 6, num. 1, art. 25. DOI: https://doi.org/10.3390/encyclopedia6010025
CHAN, Victor C. H.; ROSS, Gwyneth B.; CLOUTHIER, Allison L.; FISCHER, Steven L.; GRAHAM, Ryan B. (2022). «The role of machine learning in the primary prevention of work-related musculoskeletal disorders: A scoping review». Applied Ergonomics, vol. 98, art. 103574. DOI: https://doi.org/10.1016/j.apergo.2021.103574
EUROPEAN AGENCY FOR SAFETY AND HEALTH AT WORK (EU-OSHA) (2022). Artificial intelligence for worker management: implications for occupational safety and health. Luxemburgo: Publications Office of the European Union. DOI: https://doi.org/10.2802/76354
EZERINS, Maira E.; LUDWIG, Timothy D.; O’NEIL, Tara; FOREMAN, Anne M.; AÇIKGÖZ, Yalçin (2022). «Advancing safety analytics: A diagnostic framework for assessing system readiness within occupational safety and health». Safety Science, vol. 146, art. 105569. DOI: https://doi.org/10.1016/j.ssci.2021.105569
HUANG, Lang; WU, Chao; WANG, Bing; OUYANG, Qiumei (2018). «Big-data-driven safety decision-making: A conceptual framework and its influencing factors». Safety Science, vol. 109, pàg. 46-56. DOI: https://doi.org/10.1016/j.ssci.2018.05.012
JETHA, Arif; BAKHTARI, Hela; IRVIN, Emma; BISWAS, Aviroop; SMITH, Maxwell J.; MUSTARD, Cameron; ARRANDALE, Victoria H.; DENNERLEIN, Jack T.; SMITH, Peter M. (2025). «Do occupational health and safety tools that utilize artificial intelligence have a measurable impact on worker injury or illness? Findings from a systematic review». Systematic Reviews, vol. 14, art. 146. DOI: https://doi.org/10.1186/s13643-025-02869-1
LI, Yang; SANMIQUEL, Lluis; ZHANG, Zhengxin; ZHAO, Guoyan; BASCOMPTA, Marc (2025). «Discovering the underground coal mining accident patterns in Spain from 2003 to 2021: Insights through machine learning techniques». Safety Science, vol. 181, art. 106677. DOI: https://doi.org/10.1016/j.ssci.2024.106677
LLAMAS BLÁZQUEZ, Pablo (2025). «Predicting workplace absenteeism using machine learning: A pilot study in occupational health». Journal of Occupational Medicine and Toxicology, vol. 20, art. 38. DOI: https://doi.org/10.1186/s12995-025-00482-5
LUO, Xixi; LI, Xinchun; GOH, Yang Miang; SONG, Xuefeng; LIU, Quanlong (2023). «Application of machine learning technology for occupational accident severity prediction in the case of construction collapse accidents». Safety Science, vol. 163, art. 106138. DOI: https://doi.org/10.1016/j.ssci.2023.106138
MAHERONNAGHSH, Sara; ZOLFAGHARNASAB, Hooshiar; GORGICH, Malihe; DUARTE, J. (2023). «Machine learning in Occupational Safety and Health – A systematic review». International Journal of Occupational and Environmental Safety, vol. 7, num. 1, pàg. 14-32. DOI: https://doi.org/10.24840/2184-0954_007-001_001586
MERMER, Omer; ZHANG, Eddie; DEMIR, Ibrahim (2026). «Explainable ensemble machine learning for predicting injury severity in agricultural accidents». Journal of Agromedicine, pàg. 1-15. DOI: https://doi.org/10.1080/1059924X.2026.2658048
OBASI, Izuchukwu Chukwuma; BENSON, Chizubem (2025). «An explainable machine learning framework for predicting injury severity in extractive industry accidents». Results in Engineering, vol. 28, art. 107552. DOI: https://doi.org/10.1016/j.rineng.2025.107552
SARKAR, Sobhan; VINAY, Sammangi; RAJ, Rahul; MAITI, J.; MITRA, Pabitra (2019). «Application of optimized machine learning techniques for prediction of occupational accidents». Computers & Operations Research, vol. 106, pàg. 210-224. DOI: https://doi.org/10.1016/j.cor.2018.02.021
TOPOLSKA, Katarzyna; WOŹNIAK, Zuzanna; HOŁA, Bożena (2026). «Application of machine learning and deep learning methods for the prediction of near misses and occupational accidents in the construction industry». Archives of Civil and Mechanical Engineering, vol. 26, art. 244. DOI: https://doi.org/10.1007/s43452-026-01606-2
TORRENT-SELLENS, Joan (2025). Inteligencia artificial y trabajo: hacia la complementariedad de inteligencias. Universitat Oberta de Catalunya.
UMAR, Mubarak; HAQUE, Faizanul (2026). «Health and safety in the construction industry: A scoping review of challenges and emerging technologies». Discover Civil Engineering, vol. 3, art. 175. DOI: https://doi.org/10.1007/s44290-026-00563-2
WATKINS, Deborah; BISHOP, Emma; NAYLOR, Steven; FRANKISH, Ruth; STAVES, Malcolm; DONY, John; MILLER, Paul; MCCOOL, Rachael; FERRANTE DI RUFFANO, Lavinia (2025). «A scoping review of the evidence base for the performance of leading indicators for improving safety outcomes: Available evidence, implications for practice and future directions». Journal of Safety Research, vol. 95, pàg. 530-544. DOI: https://doi.org/10.1016/j.jsr.2025.10.024
YAPI, Aho; LATOUCHE, Pierre; GUILLIN, Arnaud; BAILLY, Yan (2026). «A new machine learning framework for occupational accidents forecasting with safety inspections integration». Journal of Safety Research, vol. 97, pàg. 244-260. DOI: https://doi.org/10.1016/j.jsr.2026.03.004
BARAZA, Xavier; TORRENT-SELLENS, Joan; MIR-TUTUSAUS, Josep-Anton. «De la prevenció reactiva a la prevenció predictiva: com les dades i la IA estan transformant la seguretat i salut laboral». Oikonomics [en línia]. Novembre 2026, núm. 27. ISSN 2339-9546. DOI: https://doi.org/10.7238/o.n27.2611
ODS
 Xavier Baraza
Professor agregat de Seguretat i Salut Laboral i director dels Estudis d’Economia i Empresa de la Universitat Oberta de Catalunya. És investigador del grup de recerca interdisciplinària i2TIC-IA Lab (UOC-DIGIT) i centra la seva recerca en l’anàlisi de la macroaccidentalitat en diversos sectors d’activitat, l’evolució de les competències dels professionals de la seguretat i salut laboral i la modelització d’accidents químics industrials. Enginyer Químic (UB, 1999), doctor en Enginyeria Química (UB, 2002) i màster en Química Experimental (UB, 2000), Prevenció de Riscos Laborals (UPC, 2003) i Direcció i Administració d’Empreses (EEN, 2007).
 Joan Torrent-Sellens
Catedràtic d’Economia, director del Centre de Recerca en Transformació Digital i Governança (UOC-DIGIT) i coinvestigador principal del grup de recerca interdisciplinària en TIC i Laboratori d’IA (i2TIC-IA Lab). La seva recerca se centra en l’economia política de la intel·ligència artificial i els seus efectes econòmics, empresarials, laborals, de benestar i salut i de sostenibilitat dels processos de transformació i transició digital. Llicenciat en Ciències Econòmiques i Empresarials (UAB, 1994), màster en Anàlisi Econòmica (UAB, 2001) i doctor en Economia (UOC, 2002).
 Josep-Anton Mir-Tutusaus
Professor lector de Big Data i Business Intelligence dels Estudis d’Economia i Empresa de la Universitat Oberta de Catalunya. És investigador del grup TURBA Lab (UOC-TRÀNSIC) i centra la seva recerca en la intersecció entre les ciències ambientals, les ciències socials i la intel·ligència artificial mitjançant l’anàlisi quantitativa i el machine learning. El seu treball busca desmuntar el discurs «immaterial» de la tecnologia, analitzant el cost físic (petjada hídrica, petjada de carboni i extracció de materials), i també el cost social i laboral de la transformació que produeix la intel·ligència artificial. Doctor en Ciència i Tecnologia Ambientals (ICTA-UAB, 2017), llicenciat en Biotecnologia (UAB, 2012) i màster en Bioinformàtica i Bioestadística (UOC-UB, 2023).


